Inteligência Artificial na Literatura: O que a IA Já Mudou no Mercado Editorial Brasileiro e Mundial
O que a IA já mudou no mercado editorial brasileiro e mundial? Análise completa sobre geração de texto, tradução, audiolivros e o impacto real nos leitores.
Em março de 2026, uma youtuber que fala de livros para um público modesto publicou um vídeo de quase três horas com um título deselegante: ela achava que aquele romance era lixo de IA. O livro era Shy Girl, de Mia Ballard, um horror publicado no Reino Unido pela Hachette depois de virar fenômeno na autopublicação. O vídeo passou de um milhão de visualizações. O New York Times pegou o caso. Vinte e quatro horas depois da reportagem sair, a Hachette cancelou a edição americana e tirou o livro de circulação no Reino Unido. Guarde essa cronologia, porque ela é o resumo da história inteira: o leitor percebeu antes da editora.
Não foi um algoritmo de detecção instalado no fluxo editorial que pegou o problema. Não foi o editor de aquisição, não foi o preparador de texto, não foi o agente. Foi uma pessoa lendo com atenção, incomodada com a quantidade de vezes que a palavra "afiado" aparecia, e depois um monte de gente no Reddit comparando notas. A indústria só reagiu quando um jornal grande apontou a câmera para ela.
Eu passei as últimas semanas lendo relatórios, estudos, processos judiciais e reportagens sobre inteligência artificial na literatura, e a coisa que mais me incomodou não foi a tecnologia. Foi a reação a ela. De um lado, um pessoal vendendo a ideia de que agora qualquer um publica quarenta livros por ano e vira empreendedor literário. Do outro, um pânico que já cancelou contratos de autores que podem ser inocentes com base em software que erra. E no meio, silêncio de quem deveria estar fazendo o trabalho.
Este texto é longo. É opinativo e eu não vou fingir neutralidade, mas prometo separar com clareza o que é dado do que é minha leitura do dado. Minha posição, resumida em uma frase antes de começar: o problema não é a máquina escrever romances ruins — é que o mercado editorial já tinha esvaziado o valor econômico da autoria antes da IA chegar, e a IA só está acelerando um processo que a própria indústria montou.
O que você vai encontrar aqui
- • Os números que importam (e os que não importam)
- • Uma história curta de uma inevitabilidade anunciada
- • A máquina escreve: o que ela faz bem e o que ela trava
- • As capas: onde a IA já ganhou a guerra
- • A cadeia invisível: tradução, revisão, áudio, diagramação
- • Shy Girl: anatomia de um flagrante mal feito
- • O detector virou o problema
- • A diluição: o que o estudo de Stony Brook realmente mostra
- • O Brasil: um mercado pequeno, caro e exposto
- • Os tribunais: 1,5 bilhão de dólares e um precedente incômodo
- • O leitor: o que ele diz e o que ele faz
- • Cinco apostas minhas sobre os próximos anos
- • O que dá para fazer, de verdade
- • Perguntas frequentes
Os números que importam (e os que não importam)
Vamos começar pelo chão firme, porque tem muita estatística circulando por aí que não sobrevive a cinco minutos de verificação.
O dado mais sólido que existe hoje sobre inteligência artificial na literatura de ficção veio de uma pesquisa divulgada em julho de 2026 por Tuhin Chakrabarty e Xinyue Liu, da Universidade Stony Brook, Jane Ginsburg, da Faculdade de Direito de Columbia, e Paramveer Dhillon, da Universidade de Michigan. Eles pegaram 14.419 e-books de ficção de gênero auto publicados na Amazon entre janeiro de 2023 e março de 2026, passaram o texto completo por um detector de IA e cruzaram cada título com o histórico diário de vendas até junho de 2026.
O que encontraram:
- 2.880 livros — cerca de 20% da amostra — tinham mais de 25% da prosa sinalizada como gerada por máquina.
- 2.168 livros passavam de 50%.
- Quase mil romances estavam acima de 90%.
- Nenhum deles informava isso ao leitor.
Esse último ponto é o que dá o tom. Não se trata de um mercado paralelo de livros declaradamente sintéticos, com etiqueta na capa, que o leitor escolhe comprar ou não. Trata-se de vinte por cento de uma prateleira inteira sem aviso nenhum.
O estudo ainda não passou por revisão por pares, e isso precisa ser dito. Mas a metodologia é razoavelmente transparente e o número que mais me chamou atenção não é a porcentagem de livros com IA. É o desenho econômico.
Em três anos, o catálogo medido cresceu 38,3 vezes. O número de títulos com vendas registradas em um trimestre cresceu 19,2 vezes. E o faturamento trimestral cresceu 8,9 vezes.
Leia de novo, devagar. O número de livros disputando o mesmo bolso multiplicou por quase vinte. O bolso multiplicou por nove.
Isso tem nome: diluição de mercado. Cada livro vendido passa a valer menos. E os autores que mais perderam terreno, segundo os pesquisadores, foram justamente os que não usaram IA nenhuma, nos gêneros onde a adoção foi maior. Dhillon descreveu o mecanismo à Fortune sem rodeios: a maioria desses livros é ruim, mas alguns são bons o suficiente para subir no ranking, e a competição espreme quem já estava na margem.
Fora da ficção, o cenário é pior. Um levantamento da Originality.AI analisou mais de dois mil livros de religião publicados na Amazon em doze meses e sinalizou 1.272 títulos — 63% — como provavelmente escritos por modelos de linguagem. Religião, autoajuda, negócios, guias práticos: são os nichos onde o leitor procura uma resposta, não uma voz, e onde o texto genérico passa despercebido com mais facilidade.
O que os números de "adoção" não dizem
Aqui entra minha primeira briga com a conversa pública sobre o tema.
Circula muito uma estatística do tipo "45% dos autores já usam IA" ou "50% dos profissionais do setor editorial já usam IA". A pesquisa da BookBub com mais de mil autores em 2025 aponta perto de 45%; o relatório do Cerlalc sobre o setor editorial ibero-americano aponta metade dos profissionais consultados; a BookNet Canada chegou a números parecidos em 2026.
Esses números são verdadeiros e quase inúteis.
Porque "usar IA" numa pesquisa de opinião é uma categoria que engloba o autor que pediu ao ChatGPT três nomes para uma vila fictícia e o sujeito que gerou duzentos romances em um ano. São coisas que não têm relação entre si. Perguntar "você usa IA?" para um profissional do livro hoje é como perguntar "você usa internet?" em 2005 — a resposta é sim para quase todo mundo e não te diz absolutamente nada sobre o que essa pessoa faz.
Pior: são dados autodeclarados sobre um comportamento estigmatizado. Quem usa muito tem incentivo para dizer que usa pouco. Quem não usa nada tem incentivo para dizer que nunca tocou no assunto. O número real de uso pesado é, quase com certeza, maior do que as pesquisas mostram.
O que me parece mais confiável é a distribuição das preocupações, que é consistente entre países. No levantamento do Cerlalc, a angústia com IA aparece assim, por ocupação:
| Ocupação | % Preocupados |
|---|---|
| Ilustradores | 74% |
| Tradutores | 60% |
| Designers | 47% |
| Escritores | 45% |
Repare na ordem. Quem mexe com imagem está mais assustado do que quem mexe com texto. E está certo. Voltaremos a isso.
Uma história curta de uma inevitabilidade anunciada
Uma coisa que atrapalha o debate é a sensação de que tudo isso caiu do céu em novembro de 2022. Não caiu. A ideia de máquina escrevendo literatura é velha e os avisos estavam todos lá.
2016. Um grupo de pesquisadores japoneses inscreveu no prêmio literário Hoshi Shinichi um conto com premissa autorreferente: um programa de computador que decide escrever um romance. O texto passou da primeira fase de avaliação. A imprensa do mundo inteiro tratou aquilo como sinal do apocalipse. Na prática, humanos tinham estruturado o enredo, escolhido as frases, montado os parâmetros e deixado a máquina preencher lacunas. Era menos "IA escreve romance" e mais "humanos usam ferramenta esquisita". Mas a manchete pegou.
2018. Ross Goodwin, designer e escritor, instalou câmera, GPS e microfone num carro e dirigiu de Nova York a Nova Orleans enquanto uma rede neural cuspia texto em tempo real num rolo de papel térmico. O resultado virou o livro 1 the Road, publicado sem nenhuma edição posterior. É ilegível como romance e fascinante como documento. Goodwin deixou os erros de propósito, exatamente para que ninguém confundisse aquilo com literatura. Foi um gesto honesto que a indústria não repetiria.
2019–2020. GPT-2, depois GPT-3, com seus 175 bilhões de parâmetros. (Vi esse número errado em mais de um material de referência, escrito como 1,75 bilhão. São 175 bilhões.) O texto começou a ficar fluente. Ainda assim, era coisa de pesquisador com acesso a API.
Novembro de 2022. ChatGPT. A barreira técnica desaparece. Qualquer pessoa com um navegador passa a poder gerar texto em volume industrial de graça.
2023. Midjourney, DALL·E e Stable Diffusion ficam bons o bastante para capa de livro. E aparece o primeiro sintoma real do que viria: Jane Friedman, uma das vozes mais respeitadas sobre o negócio do livro nos Estados Unidos, descobre que havia livros à venda na Amazon com o nome dela na capa. Ela não tinha escrito nenhum. Eram textos gerados por máquina, empacotados e publicados por terceiros que perceberam que o nome dela vendia. Quando tentou derrubar os títulos, ouviu da Amazon que precisaria comprovar direitos sobre obras que ela não tinha escrito.
Esse caso é subestimado. Ele mostrou, antes de qualquer romance falso virar best-seller, que o gargalo não era a qualidade do texto. Era a ausência total de controle de identidade e procedência na maior loja de livros do planeta.
2024–2025. A autopublicação vira fábrica. A Amazon impõe um limite de três títulos por dia por conta — um número que revela muito sobre o volume que estava chegando. Passa a exigir declaração de uso de IA no upload, sem verificar nada.
2026. O ano em que a conta chegou. Shy Girl cancelado em março. Acusações no Commonwealth Short Story Prize em maio. O acordo bilionário da Anthropic com autores homologado em julho. O contrato milionário de Jerry Falade desfeito em julho e agosto. O estudo de Stony Brook em julho. Fernando Morais processando a OpenAI em São Paulo em agosto.
Dez anos entre o conto japonês e a crise. Não foi surpresa. Foi lentidão.
A máquina escreve: o que ela faz bem e o que ela trava
Agora a parte que interessa a quem escreve. Vou tentar ser específico, porque a discussão em abstrato ("a IA pode substituir escritores?") não leva a lugar nenhum.
Onde a ferramenta funciona de verdade
Tem uso de IA na escrita que é trivialmente defensável e que eu acho meio bobo demonizar.
Pesquisa de contexto. Você está escrevendo um romance ambientado em Santos em 1932 e precisa saber como funcionava o porto, o que se comia, quanto custava um bonde. A máquina te dá um ponto de partida em segundos. Ela também vai inventar detalhes com uma confiança absoluta, então você checa tudo. Olga Tokarczuk, que ganhou o Nobel, já disse usar IA para acelerar pesquisa preliminar. Anthony Horowitz disse que usa o tempo todo e que a regra é sempre buscar uma segunda fonte. Essa é a postura correta e ela é bem menos glamourosa do que as duas narrativas concorrentes.
Desbloqueio. Você travou no capítulo onze. Pede quinze possibilidades de virada. Quatorze são clichê e uma te dá uma ideia melhor que nenhuma delas. Isso não é a máquina escrevendo por você, é a máquina funcionando como um interlocutor ruim mas incansável. Todo escritor que já teve um amigo paciente para reclamar sabe o valor de um interlocutor ruim.
Consistência interna. Em série longa, com dezenas de personagens, a máquina é boa para achar que o olho da Marina era castanho no livro um e virou verde no livro três. Isso é trabalho de continuísta, ninguém gosta de fazer, e a economia de tempo é real.
Limpeza mecânica. Concordância, repetição involuntária, vício de linguagem. Grammarly, LanguageTool, ProWritingAid fazem isso há anos e ninguém chamou de fraude.
Vou dizer uma coisa impopular em site de literatura: quem usa IA para essas quatro coisas não está fazendo nada errado e não deve satisfação a ninguém. Exigir que o autor declare que usou corretor ortográfico é tão absurdo quanto exigir que declare que usou dicionário.
Onde a coisa muda de natureza
O ponto de inflexão não é técnico, é de responsabilidade. Ele acontece quando a frase que vai para o leitor não foi escolhida por um ser humano.
E aqui a máquina é boa. Melhor do que a maioria das pessoas que reclamam dela admite. Ela produz parágrafos limpos, gramaticalmente impecáveis, com ritmo razoável e vocabulário acima da média do romance de gênero comercial. Se o padrão de comparação é o quinto volume de uma série de romance paranormal produzida sob contrato apertado, a máquina ganha em consistência.
O problema é que ela ganha em consistência porque é exatamente isso que ela faz: ela converge para a média do que já existe. E a média do que já existe é chata.
Por que o texto de IA soa como texto de IA
Vale destrinchar os tiques, porque são reconhecíveis e porque entender o mecanismo ajuda a entender o limite.
A tríade. Modelos de linguagem adoram listas de três. "Ela estava cansada, irritada e com medo." Uma vez é estilo. Quarenta vezes é assinatura. No caso de Shy Girl, o uso excessivo de construções em três foi um dos sinais apontados pelos leitores.
A repetição de adjetivo marcado. O modelo escolhe uma palavra que considera evocativa e a usa até o osso. Em Shy Girl, a palavra era sharp, "afiado". A frequência chamou atenção antes de qualquer software.
A metáfora bem construída que não significa nada. Esse é o tique mais interessante e o mais difícil de explicar para quem não escreve. A máquina produz imagens que têm a forma de uma boa imagem literária sem ter a função. No caso do Commonwealth Short Story Prize, a frase que levantou suspeita descrevia uma mulher com um jeito de andar que transformava bancos em homens. Soa a literatura. Você lê duas vezes e percebe que não descreve nada que você possa ver.
Um escritor humano constrói metáfora partindo do que ele quer que o leitor enxergue. A máquina constrói partindo do que costuma aparecer perto de metáforas. É a diferença entre um caminho e a pegada de um caminho.
A ausência de erro. Prosa humana boa tem irregularidade. Frases longas demais que o autor manteve por teimosia. Uma palavra estranha que só faz sentido para ele. Um parágrafo que quebra o ritmo porque a cena exigia. O texto de máquina tende a um platô de competência que, em volume, cansa. Editores estão relatando desconfiança de manuscrito "impecável demais", o que é uma frase nova e um pouco assustadora na história da edição.
O que a máquina não faz
E agora a parte em que eu discordo tanto do entusiasta quanto do catastrofista.
O entusiasta diz que é questão de tempo e escala. O catastrofista diz que a máquina nunca terá alma. Os dois estão respondendo à pergunta errada.
A questão não é se a máquina tem intenção. É que a literatura funciona como um contrato de atenção entre duas consciências, e esse contrato é o produto.
Quando eu leio Vidas Secas, parte do que eu estou consumindo é o fato de que um sujeito chamado Graciliano Ramos, que passou fome, que foi preso, que tinha um problema específico com adjetivo, decidiu que aquela cachorra ia morrer daquele jeito. O texto carrega o peso de uma escolha feita por alguém que tinha algo em jogo. Tirar isso não deixa o livro pior tecnicamente. Deixa o livro sendo outra coisa.
Isso não é misticismo. É uma observação sobre o que o leitor está comprando. E explica por que a divulgação de uso de IA derruba avaliações mesmo quando o leitor tinha gostado do texto antes de saber. O texto não mudou. O contrato mudou.
Mas — e este é o "mas" que me impede de assinar embaixo do pânico — esse contrato não vale igual em todo lugar. Ele é forte em ficção literária, em memória, em ensaio, em poesia. É fraquíssimo em manual de Excel, em guia de dieta, em coletânea de frases motivacionais, em livro de colorir com legenda. Boa parte do que se vende como "livro" hoje nunca teve contrato de atenção nenhum. É produto informacional em formato de códice.
E a IA vai comer essa faixa inteira. Não porque é melhor. Porque ali nunca importou quem escreveu.
O erro do setor foi ter passado quinze anos tratando essas duas coisas como se fossem a mesma indústria.
As capas: onde a IA já ganhou a guerra
Se você quiser entender o futuro da escrita, olhe para o que aconteceu com a ilustração de capa. Aconteceu antes, aconteceu mais rápido e já está praticamente consumado.
Os números são brutais em qualquer moeda. Uma capa com ilustrador profissional custa, no mercado internacional, algo entre 300 e 1.500 dólares, com prazo de semanas. No Brasil, uma capa bem feita para autor independente sai entre R$ 800 e R$ 4.000, dependendo do nome e do nível de ilustração. Um serviço de geração de capa com IA cobra dez dólares por mês e entrega quarenta variações antes do café esfriar.
Isso não é uma diferença de preço. É uma diferença de categoria econômica. Quando o custo de uma coisa cai três ordens de grandeza, ela deixa de ser uma decisão e vira um padrão.
E o lado incômodo: para uma faixa enorme do mercado, o resultado é bom o suficiente. Capa de thriller com silhueta contra céu alaranjado. Capa de romance com casal em contraluz. Capa de fantasia com castelo e névoa. São gêneros com gramática visual rígida, onde a capa precisa sinalizar categoria mais do que expressar originalidade. A máquina aprendeu essa gramática lendo dez mil capas reais. Ela reproduz a convenção com precisão.
Os limites técnicos que sobraram são mais chatos do que artísticos. Tipografia continua ruim — modelos de imagem erram letra, espacejamento, hierarquia. Sangria, lombada e fechamento de arquivo para gráfica exigem alguém que saiba o que é CMYK. Mãos ainda saem esquisitas. Nada disso é intransponível e várias dessas falhas já melhoraram entre 2023 e 2026.
A conta que não fecha para o ilustrador
Aqui entra a parte que eu acho que é sistematicamente mal discutida.
Os 74% de ilustradores preocupados no levantamento do Cerlalc não estão preocupados com "a arte". Estão preocupados com a estrutura de renda deles, que sempre funcionou assim: alguns trabalhos autorais bem pagos, sustentados por um volume grande de trabalho comercial repetitivo. Capa de livro de autoajuda, banner, ilustração de miolo, spot. A IA não está tirando o trabalho autoral. Está tirando exatamente o trabalho repetitivo que financiava o autoral.
É o mesmo padrão em várias profissões criativas e quase ninguém formula assim. O debate fica em "a máquina pode ser artista?", que é filosoficamente interessante e economicamente irrelevante, quando a pergunta real é "quem vai pagar o aluguel do ilustrador enquanto ele faz a coisa boa?".
E tem o agravante da procedência. Esses modelos aprenderam olhando imagens. Muitas delas de ilustradores vivos, com estilo reconhecível, sem consentimento e sem centavo. Um ilustrador brasileiro pode hoje ser imitado por um prompt que usa o nome dele, gerando uma capa que compete com ele por um trabalho que seria dele. É difícil achar um arranjo mais perverso.
O que se perde quando a capa é gerada
Vou defender uma posição que soa nostálgica e que eu acho que é prática.
Capa boa não é ilustração bonita. Capa boa é interpretação. O designer leu o livro — ou pelo menos o briefing honesto — e tomou uma decisão sobre o que aquele objeto quer comunicar. As capas que ficaram na memória de qualquer leitor brasileiro são decisões de design, não proezas de ilustração. A Cosac Naify construiu identidade inteira em cima disso. A Companhia das Letras tem projetos gráficos que são leitura crítica da obra.
Um gerador não interpreta. Ele ilustra o resumo. Você pede "capa de livro sobre luto em uma cidade litorânea" e ele te dá uma praia melancólica com uma figura solitária. Está tecnicamente correto e é a coisa mais óbvia possível. A obviedade é o defeito estrutural, não um bug que a próxima versão resolve.
O efeito agregado disso já é visível: prateleiras onde tudo se parece. Isso tem consequência comercial direta, porque capa também serve para diferenciar. Quando todo mundo usa o mesmo gerador com os mesmos prompts, a capa para de funcionar como sinal.
Quem vai sobreviver bem nessa faixa é o designer que faz o que a máquina não faz: conceito, materialidade, tipografia autoral, projeto gráfico de coleção. E vai sobreviver atendendo menos clientes, cobrando mais caro, para editoras que entenderam que o objeto livro precisa justificar por que não é um arquivo.
A cadeia invisível: tradução, revisão, áudio, diagramação
Quando se fala de inteligência artificial na literatura, a conversa gira em torno do autor. Só que o autor é uma pessoa numa cadeia de umas quinze. As outras quatorze estão sendo atingidas primeiro e com menos barulho.
Tradução
Esse é o caso mais dolorido, e é o mais brasileiro de todos, porque uma fatia grande do mercado editorial nacional vive de traduzir.
A tradução automática neural chegou num patamar que teria parecido ficção científica em 2015. Para texto técnico, jurídico, informativo, ela resolve com pós-edição leve. Para literatura, não resolve — mas resolve mais do que os tradutores gostariam de admitir em público, e bem menos do que as empresas de tecnologia gostariam de vender.
A Amazon lançou em 2026 o Kindle Translate, que traduz automaticamente títulos publicados no KDP entre inglês e espanhol, alemão, francês, italiano e português. O sistema avalia sozinho a qualidade antes de liberar, o autor pode revisar ou publicar direto, e os títulos traduzidos ficam identificados na loja. (Vi esse serviço atribuído ao Google em material de referência. É da Amazon.)
Observe o que isso significa para o Brasil. Um autor americano de romance de gênero que vendia só em inglês agora despeja o catálogo inteiro em português a custo zero, com rotulagem discreta, competindo com autores brasileiros dentro do nosso próprio mercado. E competindo também com editoras brasileiras que pagaram adiantamento, pagaram tradução profissional e precisam recuperar isso no preço de capa.
Os 60% de tradutores preocupados no levantamento do Cerlalc não estão sendo dramáticos. A tradução profissional cobra por palavra. Quando o custo marginal da alternativa vai a zero, a pressão sobre a tarifa é matemática, não opinativa.
O que sobra, e é uma saída real ainda que rebaixada, é a pós-edição: a máquina faz a primeira passada, o tradutor humano conserta. Funciona. Paga menos. E transforma um ofício autoral num trabalho de manutenção, o que é uma perda difícil de quantificar em planilha mas fácil de sentir em qualquer conversa com tradutor.
Minha opinião, e vou ser direto: tradução literária é reescrita, e quem acha que não é nunca comparou duas traduções do mesmo livro. A Odisseia traduzida por Carlos Alberto Nunes e a traduzida por Trajano Vieira são dois livros. Escolher entre elas é uma decisão de leitura. Uma máquina não faz essa escolha porque ela não tem uma leitura — ela tem uma média de leituras.
Mas eu também acho que defender isso exige honestidade sobre o que se está defendendo. Não dá para usar o argumento da tradução literária como escudo para o mercado inteiro de tradução, que é majoritariamente manual de instrução e relatório corporativo. Esse a máquina pega e não vai devolver.
Revisão e preparação de texto
Esse é o posto mais silenciosamente ameaçado da cadeia brasileira, e quase ninguém escreve sobre isso.
Revisão de texto no Brasil já era mal paga, majoritariamente PJ, sem vínculo, com prazos que beiram o absurdo. Muito preparador ganha por lauda em valores que não mudam há anos. A máquina faz a camada mecânica — ortografia, concordância, padronização, repetição — com competência alta e custo praticamente nulo.
O que ela não faz é a camada que justifica o ofício: perceber que o narrador mudou de tom sem motivo, que a cena do capítulo sete contradiz a do quatro, que aquela piada não funciona em português do Brasil, que o autor está imitando alguém e não percebeu.
O risco não é a extinção do revisor. É a reclassificação do revisor. Se a editora passa a enxergar revisão como "aquilo que o software já fez, e alguém precisa dar uma conferida", o preço despenca e o cargo vira checagem. Já vi isso acontecer em outras áreas. O trabalho não some. Ele vira mais barato e menos qualificado, e as pessoas boas saem.
E tem um efeito perverso que apareceu com força no caso Shy Girl: a preparação de texto terceirizada, mal remunerada e sem controle virou porta de entrada de IA no manuscrito sem o autor saber. Volto nisso.
Audiolivro
Aqui a conta é ainda mais escancarada que a das capas. Narração humana profissional de um livro custa de mil a cinco mil dólares, com estúdio, direção e edição. Voz sintética de boa qualidade custa entre cinquenta e duzentos.
A tecnologia ficou boa. Não é indistinguível — ainda tem uma planura emocional que aparece em cena de tensão ou em diálogo com sarcasmo —, mas para não-ficção, autoajuda, conteúdo técnico e catálogo antigo de baixa demanda, resolve. E resolve para uma faixa de livros que nunca teria audiolivro nenhum, o que é um ganho real de acessibilidade que não deve ser ignorado por quem depende de áudio para ler.
O problema é que a mesma tecnologia clona voz. Já existem casos de vozes de narradores e autores reproduzidas sem autorização. A discussão sobre direito de imagem e voz, que parecia um tema de advogado de celebridade, virou questão trabalhista concreta.
O desenho mais provável é o que já apareceu em outros mercados: dois níveis. "Narrado por [nome do narrador]" como produto premium, voz sintética como padrão. E aí a pergunta vira quanto o leitor paga a mais pelo humano — o que é a mesma pergunta que vai aparecer, daqui a pouco, sobre o texto.
Diagramação e metadados
Menos glamouroso e igualmente relevante. Distribuição automática de texto, controle de viúvas e órfãs, geração de sumário, conversão para EPUB, extração de palavras-chave, classificação em categorias, preenchimento de ONIX. Tudo isso é automatizável e boa parte já está automatizada.
É trabalho que sustentava freelas e pequenos estúdios. Não vai gerar manchete quando desaparecer. Vai simplesmente sumir da planilha de custos das editoras, e as pessoas que faziam isso vão fazer outra coisa.
Quando eu somo tradução, revisão, ilustração, narração e diagramação, o que eu vejo não é "a IA vai substituir escritores". É um esvaziamento da classe média técnica da indústria do livro — o pessoal que não aparece na orelha, não vai em festival literário e sustenta o produto final. Essas pessoas estão sendo atingidas agora, em 2026, enquanto a conversa pública discute se a máquina tem alma.
Shy Girl: anatomia de um flagrante mal feito
Preciso destrinchar esse caso com cuidado, porque ele virou o exemplo que todo mundo cita e quase ninguém conta direito.
Os fatos, na ordem. Mia Ballard autopublicou Shy Girl em fevereiro de 2025. O livro foi bem, chamou atenção, e a Hachette comprou os direitos, lançando no Reino Unido em novembro de 2025 pelo selo Orbit. Vendeu cerca de 1.800 exemplares impressos. A edição americana estava marcada para a primavera de 2026.
A partir do lançamento britânico, leitores começaram a reclamar. Goodreads, Reddit, YouTube. Um vídeo do canal frankie's shelf, com cerca de duas horas e meia, dissecou o livro apontando repetição obsessiva de palavras, construções em três e outros padrões. Chegou a 1,2 milhão de visualizações.
Em 19 de março de 2026, o New York Times publicou uma reportagem sobre IA na ficção e a despreparação das editoras. No texto, o jornal trazia a análise de Max Spero, fundador da Pangram, empresa de detecção: o software apontava cerca de 78% do texto como gerado por máquina. No dia seguinte, a Hachette cancelou a edição americana e descontinuou a britânica, com uma nota institucional sobre compromisso com a expressão criativa original. À imprensa, a editora afirmou ter feito uma investigação longa antes de decidir.
Ballard negou. Disse ao Times que não usou IA e que um editor freelance contratado por ela, antes da compra pela Hachette, teria introduzido alterações geradas por máquina sem o conhecimento dela. Anunciou que tomaria medidas legais contra essa pessoa.
Por que eu acho esse caso mal resolvido
Primeiro, o óbvio: o livro passou por uma editora do porte da Hachette, foi adquirido, editado, produzido, lançado e ficou meses à venda sem que ninguém internamente levantasse a mão. Quem levantou foi uma youtuber e um jornal.
Isso deveria ter sido a manchete. Não foi. A fúria do público se dirigiu quase inteiramente à autora, e a editora saiu do episódio como quem tomou uma atitude firme. Tomou atitude firme vinte e quatro horas depois de um jornal grande ligar perguntando.
Segundo, e mais grave: há uma questão séria sobre o que exatamente foi analisado. Quando o relatório da Pangram foi divulgado publicamente, analistas que examinaram o documento notaram que o texto submetido ao detector carregava marcas de um arquivo do OceanofPDF, site conhecido de pirataria. Se isso procede — e a crítica circulou de forma detalhada, com prints, sem desmentido público equivalente —, então o número que derrubou a carreira de uma autora não foi extraído do manuscrito original nem da edição revisada pela Hachette, mas de uma cópia pirata de qualidade desconhecida.
Eu não sei se Mia Ballard usou IA. Ninguém que está lendo este texto sabe. O que eu sei é que o processo que decidiu isso não foi desenhado para descobrir.
Terceiro, a versão dela é tecnicamente plausível e ninguém testou. Se um preparador freelance passou o manuscrito inteiro por uma ferramenta de reescrita, o texto final apresenta assinatura de máquina mesmo tendo origem humana. Isso é um problema de detecção diferente do problema "a máquina gerou do zero", e os detectores são validados principalmente para o segundo. Um texto humano reescrito por máquina e um texto de máquina produzem sinais parecidos e implicações morais completamente distintas.
E aqui está a pergunta que eu não vi ninguém fazer com a insistência devida: se um preparador contratado usa IA sem avisar, de quem é a culpa? A autora entregou um texto humano. Recebeu de volta um texto contaminado. Não tinha como saber. Se a resposta for "azar dela", então todo autor que terceiriza qualquer etapa está exposto a um risco que ele não controla e que pode destruir a carreira dele.
O que eu acho que esse caso realmente ensina
Que a indústria não tem procedimento. Tem reflexo.
Não existia, na Hachette ou em qualquer outra grande editora, um processo definido de verificação de procedência. Não existia critério publicado para o que constitui uso inaceitável. Não existia direito de defesa, perícia contraditória ou instância de recurso. Existia um vácuo, e quando a pressão pública chegou, o vácuo foi preenchido pela decisão mais rápida disponível: cancelar e emitir nota.
Uma indústria que destrói carreiras por reflexo não está protegendo a literatura. Está protegendo o balanço.
O detector virou o problema
Essa é a parte em que eu mais me afasto do consenso do meio literário, então vou desenvolver com calma.
Depois de Shy Girl, a detecção de IA virou a solução mágica do setor. Se o problema é texto de máquina passando por humano, basta um software que identifique texto de máquina. Simples.
Não é simples. E a corrida atrás dessa solução está produzindo dano.
Como esses softwares funcionam, em linguagem de gente
Detectores de IA olham para propriedades estatísticas do texto. Duas medidas dominam:
Perplexidade é o quanto um modelo de linguagem se "surpreende" com a próxima palavra. Texto gerado por máquina tende a ter perplexidade baixa, porque a máquina escolhe palavras prováveis por construção.
Burstiness é a variação de complexidade e tamanho entre frases. Gente escreve de forma irregular: um período de quarenta palavras, depois três de seis. Máquina tende ao regular.
Em cima disso, treina-se um classificador com milhões de exemplos rotulados, e ele cospe uma porcentagem.
Essa porcentagem é o problema, e é onde a comunicação falha de forma quase criminosa. Quando um relatório diz "78,3% de IA", o leitor comum entende "78,3% do texto foi escrito por máquina". Não é isso. É uma estimativa probabilística agregada, produzida por um modelo estatístico, com margem de erro que raramente é comunicada. O decimal dá ao número uma aparência de medição laboratorial que ele não tem.
As taxas de erro, e por que 0,01% não é pouco
A Pangram, que virou a empresa central dessa história, reporta taxas de falso positivo extremamente baixas — na casa de 0,01% a 0,04%, dependendo da versão. Vamos supor que seja verdade nas condições em que foi medido.
Mesmo assim: aplique isso a uma editora que recebe cinquenta mil submissões por ano. São cinco a vinte autores inocentes marcados. Cada um deles é uma pessoa cuja carreira pode terminar ali, sem recurso, com base num número.
E essas taxas são medidas em condições controladas: texto longo, em inglês, gerado pelos modelos que o detector conhece. Fora dessas condições, a coisa degrada. Texto curto degrada. Texto em português degrada. Texto reescrito por humano depois de gerado degrada. Texto humano reescrito por máquina — o caso Ballard — é um problema para o qual essas validações não respondem direito.
O viés que ninguém quer olhar de frente
Aqui a coisa fica feia.
Detectores de IA penalizam sistematicamente quem escreve com vocabulário mais contido e sintaxe mais regular. Pesquisas sobre detecção em ambiente educacional já mostraram esse padrão com falantes não nativos de inglês. Faz sentido mecanicamente: prosa mais simples e uniforme parece estatisticamente com prosa de máquina.
Agora pense em quem, no mercado editorial anglófono global, escreve em inglês como segunda língua. Autores nigerianos, indianos, brasileiros, filipinos. Pense em quem escreve prosa deliberadamente contida por escolha estética. Pense em quem imita registro de época.
Jerry Falade, autor nigeriano, teve um contrato de 2,4 milhões de dólares com a Minotaur, selo da Macmillan nos Estados Unidos, desfeito em julho de 2026. O romance policial de estreia, Call Me, I'll Hide the Body, tinha ido a leilão com catorze editoras disputando e os direitos britânicos vendidos por seis dígitos à HarperCollins. Os agentes, Marc Gerald da Europa Content e Sandy Hodgman, retiraram o livro do mercado dizendo que não conseguiam mais autenticar como o manuscrito havia evoluído da origem à conclusão.
Falade nega ter usado IA. E levantou um ponto que eu não consigo descartar: segundo ele, três autores negros receberam contratos importantes naquele ano e os três tiveram os acordos cancelados ou interrompidos por suspeita de IA, enquanto autores brancos que declararam publicamente usar a tecnologia seguem trabalhando sem consequência.
Eu não tenho como afirmar que houve racismo. Não tenho acesso ao manuscrito, aos laudos nem às conversas internas. Mas tenho três observações que não dependem de eu saber isso.
A primeira: a agência de Falade decidiu não usar software de detecção quando um editor levantou a preocupação inicial, porque considerou a explicação dele convincente. O rompimento veio depois de uma reunião em 29 de julho em que, segundo o agente, aspectos da versão dele mudaram. Ou seja, a decisão final foi baseada em avaliação subjetiva de credibilidade, não em perícia. Avaliação subjetiva de credibilidade é exatamente o terreno onde viés racial opera.
A segunda: o padrão de prova aplicado foi invertido. Não se demonstrou que ele usou IA. Concluiu-se que não era mais possível provar que ele não usou. É um padrão impossível de satisfazer. Nenhum autor consegue provar um negativo sobre o próprio processo criativo — a não ser que tenha guardado obsessivamente cada rascunho com carimbo de data, o que ninguém fazia antes de 2024 e muita gente boa não faz até hoje.
A terceira, e a mais cínica: o livro era bom. Os próprios agentes descreveram o manuscrito como deslumbrante. Estúdios estavam disputando direitos audiovisuais. Catorze editoras leram e amaram. Se o texto era tão bom assim e ninguém detectou nada até alguém sugerir a hipótese, o que exatamente está sendo julgado — a qualidade do livro ou o conforto da indústria?
O Commonwealth Prize e a mesma armadilha
Em maio de 2026, três contos premiados no Commonwealth Short Story Prize foram acusados de uso parcial de IA. A Pangram apontou 100% em pelo menos um deles. A frase da mulher e dos bancos virou meme.
A Commonwealth Foundation investigou. Revisou rascunhos, documentos com registro de data, anotações. Não encontrou evidência. Os autores negaram.
Fim? Não. Porque a acusação já tinha circulado, e num mercado onde reputação é o único ativo de um contista, a absolvição chega sempre depois e nunca com o mesmo alcance.
Minha posição sobre detecção
Vou ser bem claro, porque acho que essa é a parte mais importante do texto.
Detector de IA não é prova. É indício. E um indício estatístico produzido por empresa privada, com metodologia não auditada publicamente, treinada em dados que não são divulgados, vendendo um produto cujo valor comercial depende de o problema parecer grande.
Isso não é acusação de má-fé. É a descrição de um conflito de interesse estrutural que existiria com qualquer empresa nessa posição. A Pangram tem 24 funcionários e levantou 13 milhões de dólares, dos quais 9 milhões em julho de 2026 — no auge exato dos escândalos que ela ajudou a produzir. Os números dela estão movendo decisões dentro de empresas com balanços centenas de vezes maiores. Uma startup pequena virou, na prática, o perito judicial não nomeado do mercado editorial mundial.
Eu não acho que a Pangram seja vilã. Acho que ela está preenchendo, por acidente de mercado, uma função institucional que nenhuma empresa privada deveria ocupar sozinha.
O que deveria existir, e não existe:
- Auditoria independente das taxas de erro, por subgrupo — idioma, origem do autor, gênero literário, extensão do texto.
- Cadeia de custódia do arquivo analisado. Se o laudo saiu de um PDF pirata, ele não vale nada. Isso é básico em qualquer perícia e foi ignorado no caso mais famoso do setor.
- Contraditório. O autor acusado deve ter direito a perícia própria, a apresentar histórico de versões, e a ser ouvido antes da decisão.
- Múltiplos detectores. Um só número não decide nada.
- Padrão de prova declarado. A editora precisa dizer, por escrito, antes, o que ela considera uso inaceitável e que evidência exige.
Nada disso é utópico. É o mínimo que se exige de qualquer processo disciplinar em qualquer setor sério. A indústria do livro está cancelando contratos milionários com menos rigor probatório do que uma comissão de ética de condomínio.
E tem uma ironia final que eu não resisto: a corrida armamentista entre gerador e detector é ganha pelo gerador. Sempre. Modelos novos aparecem mais rápido do que detectores se atualizam, e existem técnicas triviais de evasão. O sujeito que gera duzentos livros em série sabe passar o texto por uma segunda passada que apaga a assinatura. Quem não sabe é o autor honesto que usou a ferramenta uma vez para revisar um capítulo.
A detecção pega o amador honesto e deixa passar o profissional desonesto. É a pior seleção possível.
A diluição: o que o estudo de Stony Brook realmente mostra
Volto ao estudo que citei lá em cima, porque ele merece mais que um parágrafo e porque a leitura que circulou dele na imprensa é, na minha opinião, errada.
A manchete que rodou o mundo foi "livros de IA inundam a Amazon e esmagam autores humanos". Está certo e está incompleto, e a parte que falta é a mais interessante.
A hipótese que caiu
A crença confortável do setor era: esses livros são ruins, leitor percebe, eles não vendem, o mercado se autocorrige. O estudo testou isso e a hipótese não sobreviveu.
Os livros com IA vendem. Não vendem bem individualmente, mas vendem o suficiente para ocupar posição em ranking, aparecer em "clientes que compraram este também compraram", consumir palavras-chave e disputar categoria. Alguns chegam a ficar entre os lançamentos mais vendidos.
Isso demole o argumento de que a qualidade resolve. Em marketplace algorítmico, visibilidade é mais determinante que qualidade, e visibilidade é função de volume e de sinal de engajamento. Um catálogo que cresce 38 vezes em três anos sufoca o autor sem nome antes que a qualidade dele tenha chance de ser avaliada por alguém.
Onde eu discordo da leitura corrente
A tentação é concluir que a IA quebrou o mercado. Eu acho que ela apertou um mercado que já estava quebrado, e a diferença importa muito para saber o que fazer.
Pense em como a Amazon funcionava em 2019, antes de qualquer romance sintético. Já havia excesso de oferta. Já havia autores publicando sob múltiplos pseudônimos em ritmo industrial. Já havia fazendas de resenha, manipulação de palavra-chave, capa clonada de best-seller, títulos otimizados para busca em vez de para leitura. Já havia autor sério escrevendo cinco livros por ano porque o algoritmo do Kindle Unlimited premia frequência de publicação e pune silêncio.
A pressão de produção industrial sobre autores é anterior à IA. Foi criada por um modelo de distribuição que remunera atenção contínua e por uma plataforma que transformou publicação em fluxo. O que a IA fez foi remover o último atrito que ainda limitava esse sistema: o tempo que um ser humano leva para escrever oitenta mil palavras.
Quem construiu essa máquina não foi a OpenAI. Foi a indústria, ao longo de quinze anos, aceitando a lógica da plataforma sem discutir seus incentivos.
Então quando eu leio editores dizendo que a IA ameaça a literatura, a minha reação é: ameaça, sim, mas vocês passaram uma década e meia otimizando para volume e desconto, e agora chegou alguém que otimiza melhor que vocês.
A bifurcação, e por que ela é pior do que parece
Chakrabarty, um dos autores do estudo, prevê um mercado em dois trilhos: de um lado, ficção de gênero formulaica gerada em escala, muito lucrativa; de outro, ficção literária onde a qualidade da escrita humana é o produto. Ele diz, com certa resignação, que autores vão ter que escolher a que clã pertencem.
Essa previsão é provavelmente correta e eu acho que ela é péssima notícia por um motivo que quase não se discute.
A ficção de gênero comercial é o que financia a literatura. Sempre foi. Editora de prestígio paga ficção literária com dinheiro de thriller e romance. Autor literário paga aluguel com tradução, com oficina, com coluna, com o livro comercial que ele escreve sob pseudônimo. Livraria sustenta a mesa de lançamento de poesia com o giro do best-seller da frente.
Se o trilho comercial for absorvido por produção sintética de baixo custo, o subsídio cruzado que sustenta o trilho literário some. A literatura não é ameaçada diretamente pela IA. Ela é ameaçada pelo colapso do andar de baixo do prédio em que ela mora.
E o autor de meio de tabela — aquele que vende razoavelmente, não é famoso, publica um livro a cada dois anos e vive disso com dificuldade — é quem morre primeiro. Ele não tem nome que sustente o trilho premium nem volume que sustente o trilho de escala. É exatamente a faixa que o estudo mostrou perdendo mais receita.
O Brasil: um mercado pequeno, caro e exposto
Agora a parte que quase nenhuma análise internacional faz, e que muda bastante o diagnóstico.
Quase tudo que se escreve sobre inteligência artificial no mercado editorial parte de dados americanos e britânicos. O Brasil tem uma estrutura diferente o suficiente para que várias conclusões não se transfiram.
Os números brasileiros, sem maquiagem
Segundo a pesquisa Produção e Vendas do Setor Editorial Brasileiro com ano-base 2025, coordenada pela CBL e pelo SNEL com apuração da Nielsen BookData, as vendas ao mercado somaram cerca de R$ 4,5 bilhões, com alta nominal de 7,7% e crescimento real de 3,3% descontada a inflação. Foram produzidos aproximadamente 45 mil títulos e 367 milhões de exemplares.
No varejo, o Painel de Varejo de Livros da NielsenIQ BookData para o SNEL registrou R$ 3,099 bilhões em 2025, crescimento de 8,7%, com 60,3 milhões de exemplares vendidos.
Parece bom. Não é.
Primeiro, porque a CBL já mostrou que o setor encolheu 44% em quase duas décadas. O crescimento recente recupera terreno perdido, não conquista terreno novo.
Segundo, porque o crescimento foi comprado com desconto. O desconto médio aplicado em 2025 chegou a 23,9%. O presidente do SNEL, Dante Cid, observou que o setor teria movimentado perto de R$ 4 bilhões no varejo se os livros tivessem sido vendidos pelo preço de capa. Traduzindo: vendeu-se mais volume a margem menor.
Terceiro, e este é o número que devia estar em toda capa de jornal: a proporção de leitores na população brasileira caiu de 56% em 2015 para 46% em 2024, segundo a pesquisa Retratos da Leitura no Brasil. Dez pontos percentuais em menos de dez anos.
Junte as três coisas. Um mercado que encolheu no longo prazo, que cresce no curto prazo à custa de margem, e cuja base de leitores está diminuindo. Agora acrescente uma tecnologia que multiplica a oferta.
Nos Estados Unidos, o estudo de Stony Brook mediu oferta crescendo 38 vezes contra receita crescendo 9. No Brasil, a receita não está crescendo nem perto disso e a base de compradores está encolhendo. Se o mesmo fenômeno de inundação atingir aqui com a mesma intensidade, a matemática é mais cruel, não menos.
Por que o Brasil está mais exposto
Quatro razões estruturais:
- Somos importadores líquidos de tradução. Uma parte enorme do que se lê no Brasil foi escrito em outra língua. Quando o custo de traduzir cai para perto de zero e a Amazon oferece tradução automática para português direto no KDP, o catálogo internacional inteiro passa a poder desembarcar aqui sem intermediário, sem adiantamento e sem tradutor. Isso pressiona simultaneamente o autor nacional (mais concorrência) e a editora nacional (que pagou direitos e tradução para competir com algo gratuito).
- Nossa cadeia técnica é precarizada. Revisão, preparação, diagramação e tradução no Brasil são majoritariamente trabalho autônomo, sem piso, sem representação forte, com tabelas de preço estagnadas. Quando a automação chega num mercado assim, não existe anteparo. Nos Estados Unidos existe o SAG-AFTRA negociando cláusulas de IA para narração. Aqui não existe equivalente com a mesma força para nenhuma dessas funções.
- Nosso arcabouço legal é anterior ao problema e está travado. Já chego lá.
- Nossa base de leitores é pequena e está diminuindo. Num mercado com poucos compradores, a disputa por atenção é mais brutal, e o autor brasileiro de meio de tabela é ainda mais frágil que o americano equivalente.
Fernando Morais contra a OpenAI
Em agosto de 2026, o jornalista e escritor Fernando Morais protocolou ação contra a OpenAI na 11ª Vara Cível de São Paulo. É o caso brasileiro mais relevante até agora e vale entender o que ele argumenta, porque é diferente do que se discute nos Estados Unidos.
A defesa de Morais sustenta que o ChatGPT reproduz, de forma resumida ou não, conteúdo de obras dele como Chatô: o Rei do Brasil, Corações Sujos e Olga. Os advogados anexaram testes: em um deles, perguntado sobre Chatô, o sistema teria devolvido um resumo completo, dividido por capítulos. Em Olga, descrições detalhadas de episódios envolvendo Olga Benário em Ravensbrück.
O argumento jurídico se apoia na Lei 9.610/1998, que exige autorização prévia e expressa do autor para determinadas formas de utilização da obra, incluindo a inclusão em bases de dados. E sustenta que as exceções previstas na lei não se aplicariam a uma atividade de finalidade comercial que prejudica a exploração normal da obra. Morais pede indenização por danos materiais e morais e a suspensão do uso, sob multa diária. O valor da causa foi fixado inicialmente em R$ 100 mil, com o montante final a ser apurado por perícia.
Em entrevista, Morais comparou a situação a entrar numa livraria de aeroporto e encontrar seus próprios livros com o nome de outra pessoa na capa.
Por que esse caso é mais interessante do que parece
Duas coisas o distinguem dos processos americanos:
Primeira: o direito brasileiro não tem fair use. A doutrina americana de uso justo permite ao juiz ponderar propósito, natureza, quantidade e efeito de mercado. Foi exatamente por essa via que o juiz William Alsup decidiu, em junho de 2025, que treinar modelo com livros protegidos pode ser uso justo, condenando a Anthropic apenas pela aquisição pirata dos arquivos. No Brasil não existe esse teste aberto. A Lei 9.610 traz um rol de limitações relativamente fechado no artigo 46. Se o uso não cabe numa das hipóteses listadas, ele depende de autorização. É um regime mais rígido, e isso significa que uma decisão brasileira favorável a Morais é mais provável do que a mesma decisão seria nos Estados Unidos.
Segunda: o argumento dele não é só sobre treinamento. É sobre saída. Morais reclama que o sistema entrega ao usuário resumo estruturado e análise detalhada das obras, de graça, competindo com o produto que ele vende. Isso desloca a discussão de "vocês copiaram meu livro para aprender" para "vocês estão distribuindo um substituto funcional do meu livro".
É um ângulo mais forte e, na minha leitura, mais honesto sobre o que incomoda de fato. O biógrafo não perde venda porque a máquina leu o livro dele. Perde venda porque o leitor pergunta ao chatbot o que aconteceu com Olga Benário e recebe uma resposta suficiente. Se essa tese vingar em algum tribunal relevante do mundo, ela é muito mais disruptiva que qualquer discussão sobre dados de treino.
O Marco Legal da IA, ou: como travar um debate
O PL 2338/2023 foi aprovado por unanimidade no plenário do Senado em 10 de dezembro de 2024 e seguiu para a Câmara dos Deputados. Segue lá.
A votação, prevista para o fim de 2025, foi adiada para 2026 por decisão alinhada entre as presidências das duas Casas, num contexto de desgaste político e ausência de consenso. E o ponto de maior atrito é justamente o nosso: direitos autorais.
O texto aprovado pelo Senado previa que empresas de tecnologia informassem quais obras protegidas foram usadas no treinamento e assegurava aos autores o direito de vetar esse uso. O artigo 42 estabelece uma exceção de mineração de textos e dados para organizações de pesquisa, jornalismo, museus, arquivos e bibliotecas, com condicionantes — entre elas a de que o uso não concorra com a exploração normal da obra.
Na Câmara, o setor cultural pressiona por mais proteção e as plataformas resistem, alegando inviabilidade técnica. Some-se a isso um problema constitucional: o Executivo identificou vício de iniciativa no desenho de governança, porque atribuir competências normativas à ANPD implica criação de estruturas e despesas, o que só pode partir do próprio Executivo.
Resultado prático: estamos em setembro de 2026 discutindo um projeto de 2023, sobre uma tecnologia que mudou três gerações desde então, com o capítulo de direitos autorais sendo o mais disputado e o menos resolvido. E enquanto isso, a Lei 9.610/1998 — escrita quando o problema imaginável era fotocópia de apostila — continua sendo a norma que rege o assunto.
O que o Brasil deveria estar fazendo e não está
Minha lista, em ordem de urgência:
- Transparência de dados de treino como obrigação legal. Não é possível exercer qualquer direito sobre uso de obra se não se sabe que a obra foi usada. Isso é anterior a qualquer discussão sobre remuneração e é a parte mais simples de legislar.
- Gestão coletiva. O Brasil já tem estrutura de gestão coletiva no setor musical, com todos os defeitos conhecidos. Autor de livro individual não tem como litigar contra big tech — Morais é exceção porque é Fernando Morais. Uma entidade que negocie licenciamento em bloco e distribua é a única forma realista de o autor mediano ver algum dinheiro.
- Rotulagem obrigatória no ponto de venda. Se um livro foi gerado ou traduzido por máquina, isso deve estar visível para quem compra, no site e na ficha catalográfica. Não como punição, como informação. O consumidor brasileiro tem direito a saber o que está comprando, e isso já está no Código de Defesa do Consumidor em princípio.
- Posição das entidades do livro. CBL, SNEL, ANL e as associações de tradutores e ilustradores precisam de posição escrita, pública e específica. Não uma nota genérica sobre valorizar o humano. Um documento que diga o que é uso aceitável, o que exige declaração, e como se apura denúncia com direito de defesa.
- Cláusula contratual padrão. Contrato de edição brasileiro precisa tratar disso. Quem responde se o preparador usou IA? O autor pode vetar tradução automática da própria obra? A editora pode licenciar o catálogo para treinamento sem consultar o autor? Hoje a resposta para as três é "não está escrito", e "não está escrito" sempre favorece quem tem mais advogado.
Nada disso depende do PL 2338. Tudo isso pode ser feito por contrato e autorregulação, agora.
Os tribunais: 1,5 bilhão de dólares e um precedente incômodo
O caso mais importante do mundo sobre IA e livros terminou em julho de 2026, e a leitura que se fez dele no meio literário foi, na minha opinião, comemorativa demais.
O que aconteceu
Em 2024, os escritores Andrea Bartz, Charles Graeber e Kirk Wallace Johnson processaram a Anthropic alegando que a empresa havia usado milhões de livros piratas para treinar o Claude.
Em junho de 2025, o juiz William Alsup, da corte federal do Norte da Califórnia, proferiu uma decisão dividida e extremamente consequente:
- Treinar modelos de IA com livros protegidos é uso justo. Transformativo o suficiente para caber no fair use.
- Baixar e armazenar cópias piratas para montar a biblioteca interna não é. Isso vai a julgamento.
A ordem judicial consignou que a empresa havia pirateado mais de sete milhões de exemplares. Como a lei americana prevê danos de até 150 mil dólares por obra em caso de violação dolosa, o cálculo de exposição era potencialmente fatal para a empresa.
As partes fecharam acordo em agosto de 2025: 1,5 bilhão de dólares, cerca de 3 mil dólares por obra, para uma classe estimada em 500 mil livros. Alsup deu aprovação preliminar em 25 de setembro de 2025. Ele se aposentou em seguida, e a juíza Araceli Martínez-Olguín homologou definitivamente em 20 de julho de 2026, considerando o acordo justo e adequado. Mais de 91% dos 482 mil livros cobertos tiveram titulares habilitados. A empresa também ficou obrigada a destruir os arquivos originais.
É a maior recuperação por direito autoral já registrada. A Authors Guild comemorou. Justin Nelson, advogado dos autores, chamou de precedente que obriga empresas de IA a pagar titulares.
Por que eu não comemoraria tanto
Leia a decisão de novo, com atenção.
O que foi punido não foi o uso das obras. Foi o método de aquisição.
A Anthropic pagou 1,5 bilhão porque baixou de sites piratas. A conclusão prática que qualquer advogado de empresa de tecnologia tirou disso é simples: compre os livros. Digitalize legalmente. Licencie. E depois treine à vontade, porque treinar é uso justo.
A própria empresa destacou esse ponto publicamente — a decisão de Alsup estabeleceu que treinar IA com livros é uso justo sob a lei de copyright.
Ou seja: os autores ganharam 3 mil dólares por livro e perderam o argumento principal. O preço de fazer isso legalmente, a partir de agora, é o preço de capa. Uma empresa que queira treinar com 500 mil livros pode, em tese, comprá-los e pronto.
Para o autor individual, 3 mil dólares é dinheiro. Para o autor como categoria profissional, é uma indenização por um problema que acabou de ser legalizado.
Eu entendo por que as entidades comemoraram. Foi a primeira vez que alguém pagou. Mas achar que isso resolve é confundir o assentamento de uma conta com a resolução de uma questão.
O resto do mundo, em rápida sucessão
Estados Unidos. Sem legislação federal abrangente. Dezenas de processos correndo contra OpenAI, Meta, Microsoft e outras. O Copyright Office mantém a posição de que obra gerada autonomamente por máquina não é registrável — a autoria humana é requisito. Obra com contribuição humana substancial pode ser registrada, com a contribuição da máquina excluída da proteção. O caso que consolidou isso é o de Stephen Thaler e sua imagem A Recent Entrance to Paradise. (Vale corrigir uma confusão comum: DABUS é o caso de patentes do mesmo inventor, não o de direito autoral.)
União Europeia. O AI Act, Regulamento 2024/1689, classifica sistemas por risco e impõe obrigações de transparência, com multas que podem chegar a percentuais relevantes do faturamento global. A Diretiva de Copyright de 2019 já previa exceções de mineração de textos e dados, com possibilidade de reserva de direitos pelo titular. É o arcabouço mais desenvolvido do mundo, e é também o mais criticado por quem acha que transparência sobre dados de treino é tecnicamente impraticável. Não acho que seja. Acho que é caro, que é diferente.
Reino Unido. Depois de uma consulta pública em que propunha uma exceção ampla de mineração para treinamento, o governo recuou diante da reação organizada do setor criativo. Foi uma das poucas vitórias claras de autores e editoras contra a agenda de flexibilização.
Japão. Exceção de mineração bastante ampla, orientada a estimular desenvolvimento de IA. Obra gerada autonomamente não tem proteção.
China. Exige autoria humana para proteção, e ao mesmo tempo o Estado articula infraestrutura de corpus padronizado com direitos claros para treinamento — uma abordagem de política industrial que os países ocidentais não têm.
O padrão global é fácil de resumir: todo mundo concorda que máquina não é autora, e ninguém concorda sobre o que fazer com o material que a máquina leu.
O leitor: o que ele diz e o que ele faz
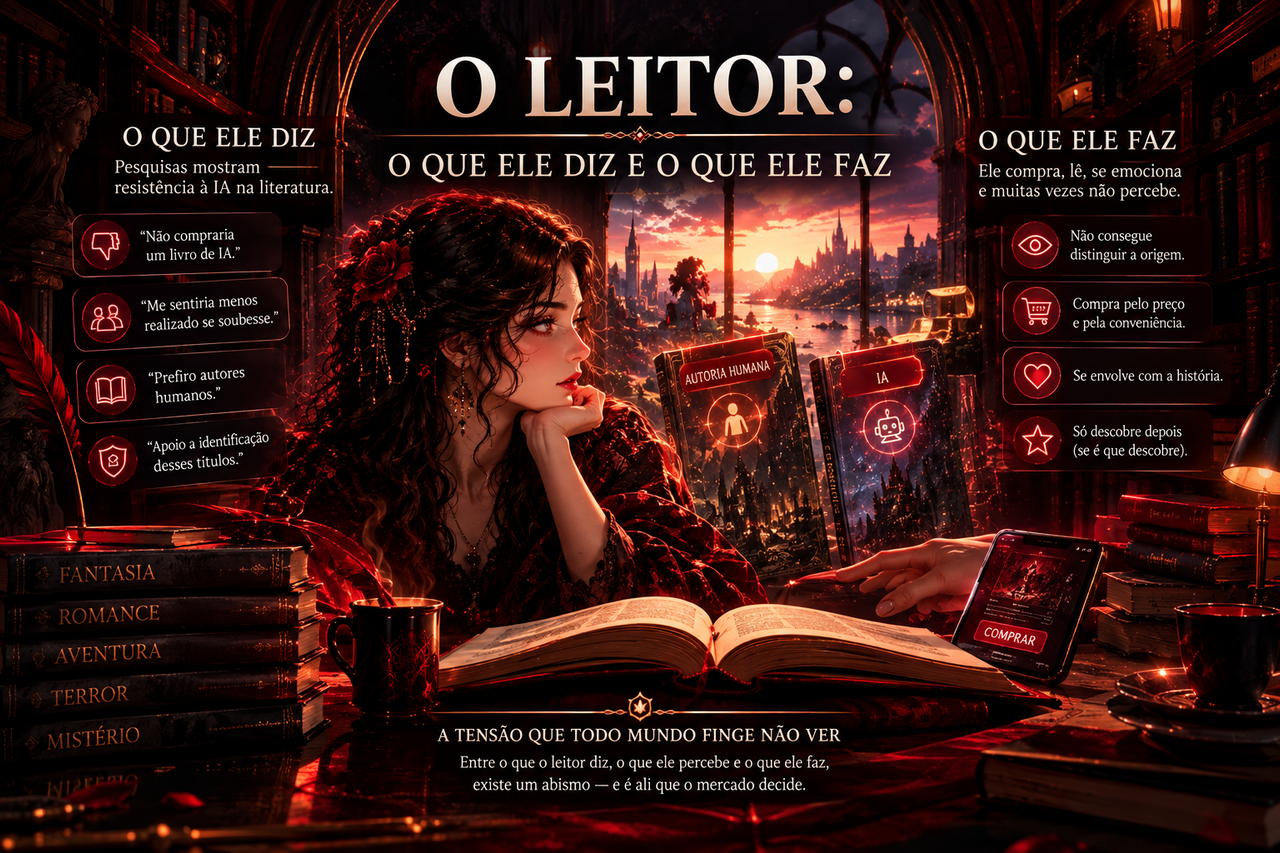
Essa é a variável que decide tudo e sobre a qual temos os piores dados.
O que ele diz
Pesquisas de atitude são consistentemente hostis. Um levantamento do YouGov nos Estados Unidos em 2025 testou cinco cenários de uso de IA na escrita, de simples ideação até finalização de texto, e a desaprovação foi maioria em todos. Cerca de 61% dos entrevistados disseram que se sentiriam menos realizados ao descobrir que um livro que leram tinha sido escrito por máquina.
Uma pesquisa da Kantar na Suécia, com mais de mil respondentes, apontou resistência declarada forte a livros gerados por IA. A Waterstones, maior rede de livrarias do Reino Unido, chegou a dizer que estocaria livros de IA claramente rotulados se os leitores quisessem, e recuou da posição. A Barnes & Noble foi mais dura: o CEO James Daunt afirmou que a rede não vende livros de IA até onde é possível saber, e que exige das editoras a identificação desses títulos.
O que ele faz
Aqui a coisa desmonta.
Estudos experimentais mostram que leitores frequentemente não conseguem distinguir origem humana de origem sintética em testes cegos, especialmente em trechos curtos e em gêneros com convenções fortes. Em tarefas restritas, saída de modelo às vezes é avaliada como igual ou superior a texto humano.
E o caso Shy Girl é o experimento natural mais eloquente: o livro vendeu, teve resenha entusiasmada, foi comprado por uma editora grande e agradou leitores durante meses. A revolta veio depois da suspeita, não antes. Gente que tinha gostado do livro se sentiu enganada — mas tinha gostado.
O caso Daggermouth, de H. M. Wolfe, é ainda mais desconfortável. Romance viral, best-seller, contrato tradicional relatado na casa dos sete dígitos, e depois um conjunto de dados de pesquisa sinalizando parte substancial do texto como provavelmente sintética. O autor nega. Independentemente de quem tenha razão, o caso quebra a equação "escrito por IA = lixo invendável".
A tensão que todo mundo finge não ver
Existe uma distância grande entre três coisas diferentes:
- O que o leitor acha da prática (hostil)
- O que o leitor consegue perceber sem ser avisado (pouco)
- O que o leitor está disposto a pagar a mais pela alternativa (desconhecido)
A terceira é a que decide o mercado, e não temos dado sério sobre ela.
Porque uma coisa é responder "eu não compraria um livro de IA" numa pesquisa telefônica. Outra é estar na livraria escolhendo entre um romance de R$ 89,90 com selo de autoria humana e um de R$ 19,90 sem selo, no aperto do mês, num país com 46% de leitores e renda apertada.
Eu quero acreditar que o selo humano vai valer. Mas o histórico de certificação de origem em outros mercados é mediano. "Orgânico" funcionou parcialmente, com fiscalização estatal, décadas de construção cultural e para um público de renda alta. "Comércio justo" funcionou menos. "Artesanal" foi capturado por marketing quase imediatamente.
Se o selo de autoria humana virar mais um adesivo na capa sem auditoria por trás, ele vira ruído em dezoito meses. E a única auditoria disponível hoje é... detector de IA. Com todos os problemas que já descrevi.
Esse é o nó real: não existe hoje uma forma confiável e justa de certificar autoria humana em escala. Qualquer proposta de mercado premium baseada em certificação esbarra nisso.
A única saída que eu vejo que não depende de detecção é a procedência documentada: histórico de versões, rascunhos datados, registro de processo. Não é prova perfeita e é chato de manter. Mas é a única coisa que olha para frente em vez de tentar adivinhar para trás.
Cinco apostas minhas sobre os próximos anos
Aqui eu saio do terreno do reportado e entro no do palpite. Estou marcando com clareza para você poder discordar de cada uma.
1. A rotulagem vai chegar, e vai chegar por consumo, não por ética
Vai haver rotulagem obrigatória de conteúdo gerado por IA em marketplace de livro, e ela vai vir de legislação de defesa do consumidor, não de legislação de direito autoral. É mais fácil aprovar "o consumidor tem direito a saber o que compra" do que resolver a questão de treinamento. A Amazon já rotula tradução automática no Kindle Translate — o precedente está posto.
Confiança: alta. Prazo: 2 a 4 anos.
2. O detector vai ser desacreditado por um erro grande e público
Em algum momento, um autor conhecido vai ser acusado com base em laudo de detecção, vai provar de forma incontestável que escreveu o texto, e vai processar alguém. Esse caso vai fazer pelo mercado de detecção o que os erros de reconhecimento facial fizeram pelo uso policial da tecnologia: não vai acabar com ela, vai forçá-la para o lugar de indício.
Dado o que apareceu no caso Shy Girl sobre a procedência do arquivo analisado, eu ficaria surpreso se isso demorasse.
Confiança: alta. Prazo: 1 a 3 anos.
3. A não-ficção prática vai ser absorvida quase inteira, e ninguém vai chorar
Guia, manual, autoajuda, livro de negócios, compilação temática. Essa faixa vai para produção sintética e o leitor não vai reclamar, porque nunca se importou com quem escreveu. Vai reclamar quando o conteúdo estiver errado, e vai estar, porque o modelo inventa com confiança.
O efeito colateral que me preocupa é sobre saúde e finanças. Livro de dieta, de suplementação, de investimento, de tratamento alternativo, gerado em escala, otimizado para busca, sem revisão técnica. Isso é um problema de saúde pública esperando manchete.
Confiança: muito alta. Prazo: já está acontecendo.
4. O mercado brasileiro vai sofrer pela tradução antes de sofrer pela escrita
Não vai ser o romance brasileiro escrito por máquina que vai machucar o setor aqui. Vai ser a enxurrada de catálogo estrangeiro traduzido automaticamente a custo zero, competindo em preço com edição nacional que pagou direitos, tradutor, preparador e revisor.
E vai ser difícil de argumentar contra, porque a tradução automática amplia acesso — é literalmente mais livro disponível em português. Vai ser um caso em que o ganho para o leitor e a perda para a cadeia são reais ao mesmo tempo.
Confiança: média-alta. Prazo: 2 a 5 anos.
5. A ficção literária vai ficar bem, e isso não é consolo nenhum
Ficção literária vai sobreviver. Vai até ganhar prestígio relativo. Prêmio, crítica, academia e leitor fiel vão continuar existindo.
O que não vai sobreviver é a economia que sustentava o autor literário: a tradução que ele fazia, a oficina, o trabalho comercial sob pseudônimo, o adiantamento razoável de uma editora com caixa. Vamos ter mais prestígio literário concentrado em menos gente que pode se dar ao luxo de escrever.
Literatura como atividade de quem tem outra fonte de renda. Já foi assim no século XIX. Seria irônico voltar para lá via tecnologia do século XXI.
Confiança: média. Prazo: 5 a 10 anos.
Uma aposta que eu não vou fazer
Não vou apostar sobre se a máquina vai chegar a escrever um grande romance. Acho a pergunta menos interessante do que ela parece e não tenho como responder.
O que eu diria é: mesmo que chegue, o problema econômico permanece idêntico. Um romance genial gerado a custo marginal zero não salva ninguém. Piora.
O que dá para fazer, de verdade
Odeio lista de recomendação genérica em fim de artigo. Vou tentar só o que é acionável e vou dizer quando eu acho que a coisa não vai funcionar.
Se você escreve
Documente o processo. Começando hoje. Essa é a única recomendação desta lista que eu considero obrigatória. Escreva em ferramenta com histórico de versões — Google Docs, Word com controle de alterações, Scrivener com snapshots, ou um repositório Git se você for desse tipo. Guarde rascunhos com data. Guarde cadernos, anotações, e-mails com o editor.
Isso soa paranoico e é exatamente o que salvou os autores do Commonwealth Prize, cuja investigação examinou rascunhos, documentos datados e anotações. O que derrubou Jerry Falade foi a impossibilidade de reconstituir o caminho do manuscrito. Não importa se você nunca tocou em IA: o ônus prático da prova está invertido e você precisa se proteger disso.
Cuidado com quem você contrata. O caso Shy Girl mostrou que preparador, revisor ou ghost freelance pode introduzir IA no seu texto sem te avisar, e a conta vai para você. Ponha por escrito. Um parágrafo simples no acordo: o prestador declara que não usará ferramentas generativas sem autorização expressa. Peça o arquivo com marcação de alterações.
Use a ferramenta se ela te ajuda, sem culpa e sem alarde. Pesquisa, consistência, desbloqueio, limpeza mecânica. Você não deve satisfação a ninguém sobre isso, do mesmo jeito que não deve sobre dicionário. Onde eu traçaria a linha, para mim: a frase que vai para o leitor é escolhida por mim. Se eu não consigo defender uma frase do meu livro, ela não é minha.
Cheque tudo que a máquina te der como fato. Um jornalista americano, Steven Rosenbaum, usou IA para resumir documentos e transcrições ao escrever um livro sobre o próprio tema e descobriu que a ferramenta havia convertido resumos em citações diretas inventadas — atribuições convincentes a fontes reais, que nunca existiram. O perigo não é a máquina escrever mal. É ela convencer com fato que não aconteceu.
Negocie IA no contrato. Seu contrato de edição precisa dizer se a editora pode licenciar sua obra para treinamento, se pode gerar tradução automática, se pode produzir audiolivro com voz sintética. Hoje a maioria dos contratos brasileiros é omissa nos três pontos, e omissão é uma resposta — favorável a quem redigiu o contrato.
O que eu não vou te recomendar: "construa uma comunidade fiel". Todo mundo diz isso, é verdade, e é inútil como conselho. Se fosse fácil, ninguém precisaria de editora. Comunidade fiel é consequência de anos de trabalho bom e um pouco de sorte, não é uma tática que você implementa na terça-feira.
Se você tem uma editora
Escreva a política antes de precisar dela. Um documento de duas páginas: o que é uso aceitável, o que exige declaração, o que é inaceitável, como se apura denúncia, quem decide, e que direito de defesa o autor tem. Publique. Vale mais um documento imperfeito e público do que um perfeito e interno.
A ausência disso foi o que transformou o caso Shy Girl em pânico. Editora sem procedimento reage a pressão pública; editora com procedimento aplica procedimento.
Não terceirize a decisão para um número. Se você vai usar detector, use como triagem para iniciar uma conversa, nunca como sentença. Rode mais de um. Exija cadeia de custódia — o arquivo analisado tem que ser o manuscrito, não um PDF que alguém achou na internet. Ouça o autor antes de decidir.
Pague a preparação de texto direito. Isso parece não ter nada a ver e tem tudo. O caso mais famoso do setor começou porque uma autora contratou preparação barata. Toda a sua exposição a risco de IA não declarada passa pela parte mais mal paga da sua cadeia. É um problema de compliance antes de ser um problema de custo.
Assuma o uso interno. Se você usa IA para triagem de originais, metadados, previsão de venda, extração de palavra-chave — e você usa —, diga. Exigir transparência do autor sem oferecer a mesma transparência é uma posição que não se sustenta em público, e quando vier à tona vai custar mais caro do que teria custado contar.
Pare de otimizar para volume. Essa é a recomendação difícil e a única estrutural. Se o seu modelo de negócio depende de publicar muito, barato e rápido, você está competindo no terreno em que a máquina é imbatível. A saída não é publicar mais rápido que a IA. É publicar coisas que só fazem sentido feitas por gente.
Se você lê
Não vire promotor amador. Sério. O impulso de acusar vai ser grande e você vai errar. Prosa simples não é prova de IA. Prosa limpa não é prova de IA. Autor que escreve em segunda língua não é suspeito. O custo de uma acusação falsa recai inteiro sobre uma pessoa, e a internet não emite retratação.
Compre direto quando der. Site da editora, livraria independente, autor. Não resolve o problema estrutural e melhora a distribuição de margem de forma marginal, o que já é alguma coisa.
Varie a fonte de descoberta. Se você só descobre livro por recomendação de algoritmo, você está lendo o que o algoritmo premia, e o algoritmo premia volume. Livreiro, resenha, indicação de gente, catálogo de editora, biblioteca, sebo. Métodos antigos e chatos que continuam funcionando melhor.
Exija rotulagem. Como consumidor, você tem direito a saber o que compra. Cobre isso das plataformas e das editoras. É a demanda mais simples de formular e a mais difícil de recusar publicamente.
Perguntas frequentes
É legal publicar um livro escrito por IA?
Publicar, sim. Não existe lei no Brasil ou nos Estados Unidos que proíba. O problema é outro: obra gerada autonomamente por máquina não tem proteção de direito autoral na maioria das jurisdições relevantes, incluindo Brasil, Estados Unidos, Reino Unido e Japão. A Lei 9.610/1998 define autor como pessoa física criadora de obra literária, artística ou científica. Na prática, um livro inteiramente gerado por máquina pode ser copiado por qualquer um sem que você tenha muito o que fazer.
Plataformas podem impor as próprias regras. A Amazon exige declaração de uso de IA no upload de títulos no KDP e limita a três publicações por dia por conta.
Como saber se um livro foi escrito por inteligência artificial?
Com certeza, você não sabe. Existem indícios: repetição excessiva de adjetivos marcados, abundância de construções em três elementos, metáforas com estrutura elegante e conteúdo vago, uniformidade de ritmo entre capítulos, ausência de idiossincrasia.
Detectores como Pangram, Originality.AI, GPTZero e Copyleaks dão uma porcentagem, mas essa porcentagem é uma estimativa probabilística, não uma medição. Eles erram, erram mais com texto curto, com texto em português e com autores que escrevem em segunda língua. Tratar resultado de detector como prova já produziu danos graves a pessoas provavelmente inocentes.
A IA vai substituir escritores?
Vai substituir uma parte grande da produção de texto que hoje é vendida em formato de livro: manual, guia prático, autoajuda, compilação, conteúdo de nicho informativo. Nessa faixa, a substituição já está em curso e é praticamente irreversível.
Na ficção literária e na não-ficção autoral, a substituição é improvável, porque o que se vende ali é a perspectiva de uma pessoa específica. O risco real não é o desemprego do escritor literário. É o desaparecimento das atividades econômicas que financiavam a vida dele — tradução, revisão, oficina, trabalho comercial.
Posso usar IA para escrever meu livro?
Legalmente, pode. Eticamente, depende do que você chama de "usar".
Pesquisa, brainstorming, verificação de consistência, revisão gramatical: não vejo problema e não acho que exija declaração. Geração de trechos que vão para o leitor sem passar por reescrita substancial: aí muda a natureza do que você está vendendo e eu acho que o leitor tem direito de saber.
Duas coisas práticas: verifique qualquer fato que a máquina produzir, porque ela inventa citações e dados com confiança total; e guarde o histórico do seu processo, porque hoje o ônus de provar autoria recai sobre você.
Editoras brasileiras aceitam livros escritos com IA?
A maioria não tem política escrita e pública sobre isso, o que é um problema. Na ausência de norma clara, o padrão que se consolidou é: o autor assina declaração de originalidade e assume responsabilidade integral pelo conteúdo. Se aparecer IA não declarada depois, a consequência contratual recai sobre o autor.
Se você vai submeter um original, pergunte antes e peça por escrito.
Quanto custa uma capa de livro feita por IA?
Serviços de geração de capa cobram entre 10 e 30 dólares por mês, com variações ilimitadas. Uma capa com designer profissional no Brasil custa de R$ 800 a R$ 4.000; no mercado internacional, de 300 a 1.500 dólares.
A diferença de preço é real e a diferença de resultado também. Gerador entrega ilustração convencional do gênero. Designer entrega interpretação, tipografia trabalhada, projeto gráfico e arquivo correto para gráfica. Para capa que precisa sinalizar categoria, o gerador resolve. Para capa que precisa diferenciar, não.
O que diz a lei brasileira sobre IA e direitos autorais?
A Lei 9.610/1998 exige autorização prévia e expressa do autor para diversas formas de utilização da obra, incluindo inclusão em bases de dados, e não tem uma cláusula aberta de uso justo como o direito americano. Isso torna o regime brasileiro mais restritivo para empresas de IA.
O Marco Legal da IA, PL 2338/2023, foi aprovado no Senado em dezembro de 2024 e continua tramitando na Câmara, com o capítulo de direitos autorais entre os pontos mais disputados. O texto do Senado previa transparência sobre obras usadas em treinamento e direito de veto dos autores.
Fernando Morais entrou com ação contra a OpenAI em São Paulo em agosto de 2026, alegando uso não autorizado de suas obras. É o principal caso brasileiro em curso.
Livros traduzidos por IA são confiáveis?
Para texto técnico e informativo, geralmente sim, com revisão. Para literatura, não. Tradução literária envolve decisões de estilo, ritmo, registro e referência cultural que a máquina não toma — ela produz uma média.
A Amazon lançou o Kindle Translate para autores do KDP, incluindo tradução para português, com rotulagem dos títulos traduzidos na loja. Se você se importa com a qualidade da tradução, verifique essa identificação antes de comprar.
Conclusão: O que fica?

Escrevi este texto ao longo de várias semanas e mudei de opinião umas três vezes no meio do caminho. Vou terminar com o que sobrou depois das mudanças.
A IA não é a vilã dessa história. Ela é o teste de estresse.
Uma indústria saudável teria absorvido essa tecnologia como absorveu o BookScan, o e-book e o audiolivro: com atrito, com barganha, com contratos renegociados e alguma gente prejudicada, mas com estrutura de pé. O que aconteceu em vez disso foi uma sucessão de improvisos. Editora cancelando livro em vinte e quatro horas porque um jornal ligou. Agência rompendo com autor por avaliação subjetiva de credibilidade. Prêmio literário acusando e desacusando em público. Uma startup de 24 pessoas virando árbitro de autoria por falta de alternativa.
Isso não é sinal de uma tecnologia poderosa demais. É sinal de uma indústria que não sabia onde tinha guardado os próprios princípios.
E o que eu mais quero que fique deste texto é isto: a maior parte do dano que se atribui à IA foi causada por decisões humanas que continuam sendo tomadas por humanos. O contrato que não prevê nada. A preparação de texto paga a preço de fome. O marketplace desenhado para premiar volume. O desconto de 24% que compra crescimento hoje e destrói margem amanhã. A política de IA que ninguém escreveu porque dava trabalho.
Nada disso é culpa de um modelo de linguagem. É culpa de gente que escolheu não decidir e agora está sendo obrigada a decidir no pior momento possível, sob pressão pública, sem procedimento.
A boa notícia, se é que é, é que decisão adiada continua sendo decisão disponível. Dá para escrever a política. Dá para pagar o revisor. Dá para pôr a cláusula no contrato. Dá para rotular. Dá para exigir contraditório antes de destruir a carreira de alguém com base num número decimal.
Nada disso depende de aprovar lei, esperar tribunal ou derrotar a tecnologia. Depende de a indústria do livro decidir o que ela é, num momento em que ficou impossível continuar não decidindo.
Sobre a literatura em si, eu estou razoavelmente tranquilo. Ela atravessou a imprensa, o folhetim, o rádio, o cinema, a televisão e a internet. Vai atravessar isso.
O que eu não sei é quanta gente vai conseguir continuar vivendo dela no caminho. E essa é a pergunta que ninguém está fazendo com a insistência que ela merece.
Se você trabalha com livros — escrevendo, editando, traduzindo, ilustrando, revisando, vendendo — e viu esse processo acontecer por dentro, escreve nos comentários. A parte mais mal documentada dessa história é justamente a que acontece longe da manchete.